把 LLM 焊死在硬件里:BitROM 的 ROM 单元 vs HNLPU 的金属线
LLM 推理有个绕不开的物理事实:自回归解码的运算强度(operational intensity)趋近 1——每个 token 都要把几百 GB 权重从存储里搬一遍。GPU 的解法是堆 HBM 带宽、堆并行;另一派人认为这是治标,主张把权重直接焊死在芯片里,让”取权重”这个动作从物理上消失。
2025 年下半年出现了两条代表路线,方向一致、手法截然相反:
- BitROM(Keio 大学, ASP-DAC 2026, arXiv:2509.08542):权重熔进 ROM 单元,单管存两个 1.58-bit 三元权重,面向边缘
- HNLPU(中科院计算所 + 寒武纪, arXiv:2508.16151):权重嵌进 M8+ 金属线拓扑,硅单元完全参数无关,面向数据中心
两条路各自回答了一个关键问题。BitROM 回答”怎么把权重塞进小面积“,HNLPU 回答”怎么让掩膜成本付得起“。第二个问题,才是硬连线方案真正的生死线。
共同的出发点:权重搬运是原罪
传统加速器(包括所有 GPU)本质是时间复用(time-multiplexing)硬件神经元——DianNao 2014 年确立的第一性原理。但 LLM 自回归解码把数据复用的机会抽干了:每生成一个 token,全量权重都要重新读一遍,运算强度 ≈ 1。调度、量化、稀疏、投机解码都只能缓解,不能根除存储带宽瓶颈。
硬连线(hardwiring)的逻辑是:既然权重每次都要用、每步都用、从不变化,为什么不把它变成电路本身?完美架构-模型匹配、零取权重开销、常量算术电路——这是极端专用化的终极形态。代价是流片后权重不可变。
路线 A:BitROM —— 把密度压进 ROM 单元
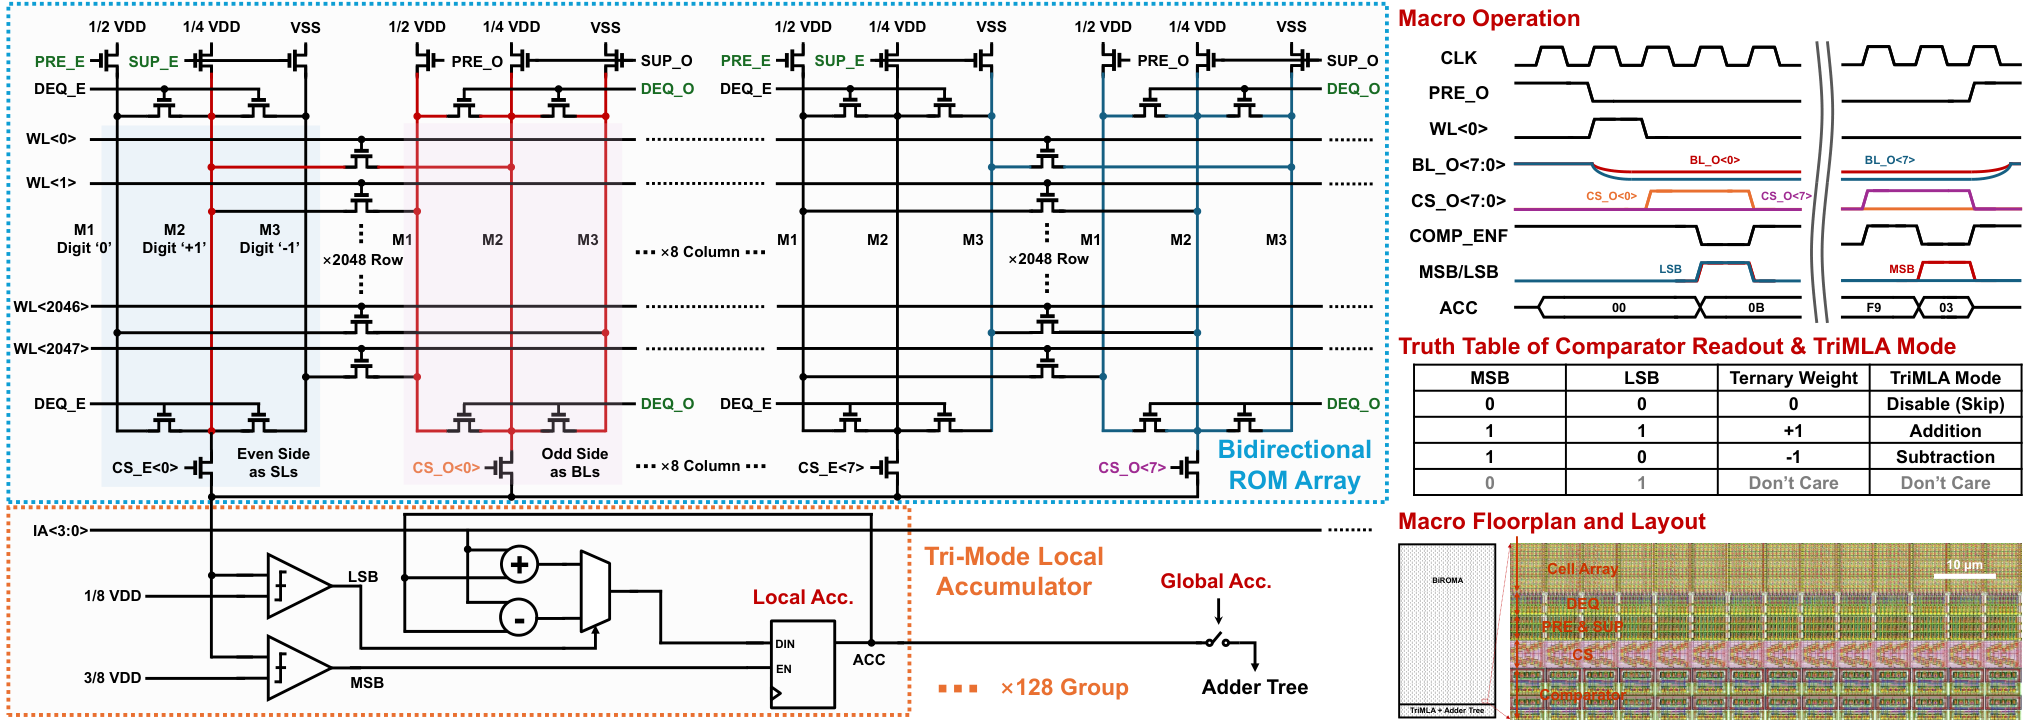
BitROM 的思路是借 BitNet 的东风:1.58-bit 三元量化把模型缩小到 ROM 塞得下的尺寸。LLaMA-7B 的权重按 CiROM 摊开要 1,000+ cm²(14nm),BitNet-1B 只要几十 cm²——这就是设计目标。
它的密度武器是 BiROMA:一个晶体管存两个三元权重(源/漏分别接代表 0、+1、-1 的三根信号线,复用两侧端口),M1/M2/M3 最小间距布线,位密度 4,967 Kb/mm²,比上一代数字 CiROM 高 10×。配套 TriMLA 做 local-then-global 累加,比较器判零直接关断累加器,白赚 BitNet 的稀疏性。65nm 后仿 20.8 TOPS/W,14nm 外推 Falcon3-1B 全模型 16.71 cm² + KV-cache eDRAM 10.24 cm²。
它的边界很清楚:面向 1B 级小模型、短序列边缘场景。ROM 单元是 2D 硅器件网格,权重密度受器件尺寸约束——这就是 Cell-Embedding 路线的天花板。
路线 B:HNLPU —— 把信息塞进金属线的 3D 拓扑
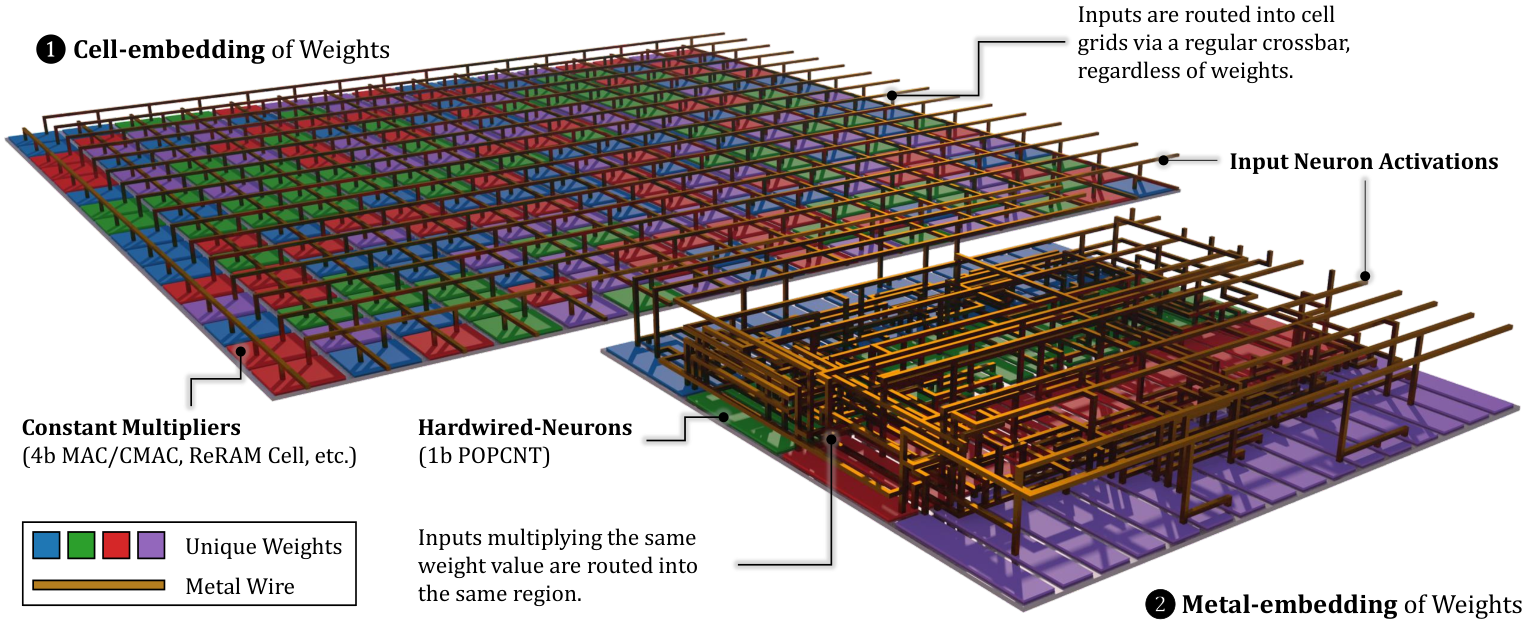
HNLPU(Hardwired-Neurons LPU)来自 DianNao 团队直系(中科院计算所 State Key Lab of Processors + 寒武纪),目标直接是 gpt-oss 120B。naive 硬连线需要 176,000 mm² 的 CMAC 阵列、拆成 200+ 芯片——这不是面积问题,是钱的问题:每颗芯片权重不同,掩膜必须全定制,200 套 × $30M = $6B NRE,经济上直接死刑。
Metal-Embedding 的破局点:权重不写在硅器件里,写进金属线的 3D 拓扑。HN(Hardwired-Neuron)单元先做公因子提取(a·x₁+a·x₂ = a(x₁+x₂))和位串行(LSB-first + CSA 树),再把 FP4 的 16 个唯一权重值各配一个 POPCNT 累加器,用金属线把输入路由到对应累加器——硅单元与参数完全无关。
这一下打开了两个盒子:
- 密度:金属线拓扑是 3D 的,信息密度天然高于 2D 器件网格 → 面积比 CMAC 网格 -93.4%,从 200+ 芯片压到 16 芯片
- 掩膜同质性:70 层掩膜里 60 层跨芯片完全共享(所有 FEOL + 关键 BEOL,包括全部 EUV 层);只有 10 层 M8+ 参数相关金属层,且可以用 193i 光学光刻(便宜)做 → 掩膜成本 -86.5%(初次流片)/-92.3%(参数更新 re-spin),总计 112× 削减
分水岭:掩膜经济学
BitROM 和 HNLPU 的密度战各有千秋,但 HNLPU 真正的贡献在于把”参数更新”变成一种可以负担的重流片。Sea-of-Neurons 架构下:预制造共享 60 层掩膜的参数无关 HN 阵列($27.7M),每个模型只需追加 10 层定制金属(+$2.3M/芯片)——换模型、更新权重,都只是换金属层的事。
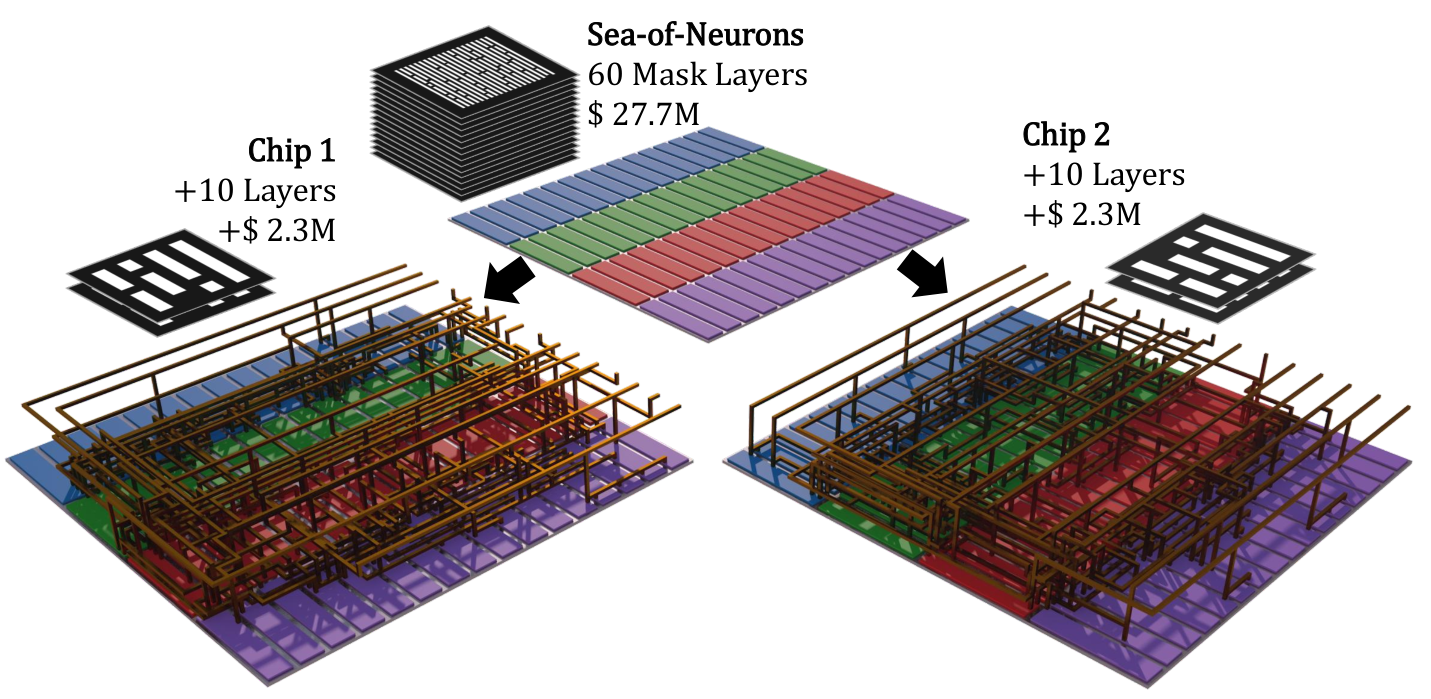
这直接回答了硬连线方案最常被质疑的问题:”权重变了怎么办?”答案是:重流片成本从 $30M/套降到 $2.3M/芯片,加上 ME 层走 193i 而非 EUV,re-spin 周期也大幅缩短。NRE 从 $6B 压到 $59–124M,进入商业可讨论区间。
直接对比
| 维度 | BitROM | HNLPU |
|---|---|---|
| 来源 | Keio 大学(ASP-DAC 2026) | ICT CAS + 寒武纪(arXiv 2025) |
| 权重载体 | ROM 单元(1 管 2 三元权重) | M8+ 金属线 3D 拓扑 |
| 量化 | BitNet 1.58-bit 三元 | FP4 |
| 目标模型 | Falcon3-1B(18 层) | gpt-oss 120B(36 层, MoE 128 exp) |
| 场景 | 边缘(32–256 序列) | 数据中心(4U 机箱) |
| 工艺 | 65nm(14nm 外推) | 5nm |
| 面积 | 16.71 cm² + 10.24 cm² eDRAM(14nm) | 16 × 827 mm² = 13,232 mm² |
| 能效 | 20.8 TOPS/W | 36 tokens/J(1,047× H100) |
| 吞吐 | 边缘单流 | 249,960 tokens/s(5,555× H100) |
| 掩膜策略 | 标准 ROM 流程 | 60/70 层共享 + 193i 定制金属 |
| 运行时适配 | LoRA 旁路(0.3% 参数) | 无(完全焊死,仅 re-spin) |
| NRE 逻辑 | 标准流片 | $6B → $59–124M(112× 削减) |
PD 视角:这是两种不同的工程美学
对做物理设计的人来说,这两篇分别展示了后端的两极:
BitROM 是”密度工程”。M1-M3 最小间距的三线信号路由、E/O 双侧对称的双向读出、外设只占 4.8% 面积——把存储密度从单元级做到布线级,是教科书级的版图功夫。65nm 标准数字流程即可后仿验证,工程落地路径清晰。
HNLPU 是”制造经济学工程”。它的核心创新不在电路,在于重新定义了掩膜的复用边界:把参数依赖从整个工艺堆栈里剥离出来,压缩进 10 层高层金属。M8-M11 布线密度 <70%、零 overflow、DRC/LVS clean、寄生 R=164Ω/C=7.8fF——论文确实做了 sign-off 级验证。HN Array 占 69.3% 面积却只消耗 24.9% 功耗(MoE 每步激活 4/128 experts),功耗密度 0.3 W/mm²,2.5D 封装热预算轻松。
一句话:BitROM 赢在单位面积塞进多少权重,HNLPU 赢在单位美元做出多少权重。
冷静判断
两篇论文都值得读,但都要带着怀疑:
- 都没有流片。BitROM 是 65nm 后仿,HNLPU 是 5nm 后布局估算 + CNSim 系统建模。5,555×、1,047× 这些数字在真实硅面前都只是估算。
- HNLPU 的商业模式没有先例。”60/70 层共享掩膜 + 定制金属”需要 foundry 配合做预制造标准化阵列——现实中还没有厂商提供这种服务,这是论文最大的隐含假设。
- BitROM 的 LoRA 是实用主义:ROM 焊死但留了旁路,0.3% 参数即可迁移任务;HNLPU 则彻底赌单一模型统治——”cognitive substrate”的通用性来自一个主导模型的泛化,不是硬件可重编程性。
- HNLPU 的经济分析敏感:TCO 在 annual-update 假设下才 break-even(低量场景 $96.6–197.8M vs H100 集群 $191.2M,区间上下限差 2×);掩膜价格、晶圆价格都来自引用而非实测。
总结
两条路线回答的是同一个问题:当权重不再变化,硬件能多激进? BitROM 说”把权重熔进 ROM,边缘跑 1B 模型”;HNLPU 说”把权重画进金属线,数据中心跑 120B 模型”。一个用单元密度解决规模,一个用掩膜复用解决成本。它们共同的潜台词是:模型-硬件协同设计的下一站,不是更大的 HBM 堆叠,而是重新定义”权重在哪里”。对硬件工程师来说,这两篇合起来是一份完整的”极端专用化”路线图——顺便说一句,HNLPU 里能看到 DianNao 到寒武纪 12 年的技术积累,而 BitROM 展示了学术团队如何在 65nm 上做出 10× 的密度突破。硬连线 LLM 的浪潮可能比我们想象的更近。
-
BitROM: arXiv:2509.08542 代码 - HNLPU: arXiv:2508.16151
— Youmoo(㕛木) Solid as teak.