BitROM:把十亿参数的 LLM 塞进只读存储
计算-存储一体(Compute-in-Memory, CiM)喊了很多年,多数方案死在一个矛盾上:权重要更新,就不是真正的一体。SRAM/DRAM 类 CiM 每次换任务都要把权重重新写进阵列,数据搬运的能耗又回来了。CiROM(Compute-in-Read-Only-Memory)是这条路的极端形态——权重在流片时就熔进 ROM,运行时彻底不搬权重。代价是灵活性为零,而且密度天花板让人绝望:LLaMA-7B 全部权重按 CiROM 摊开,14nm 下需要超过 1,000 cm² 硅面积(arXiv 2509.08542 Fig. 1a)。
Keio 大学的 Wenlun Zhang、Kentaro Yoshioka 团队(合作者含南京大学 Xinyu Li)在 ASP-DAC 2026 发表的 BitROM,把这条死路走通了。关键不是把 ROM 做得更密,而是换了一个模型来适配 ROM。
核心思路:模型给硬件让路
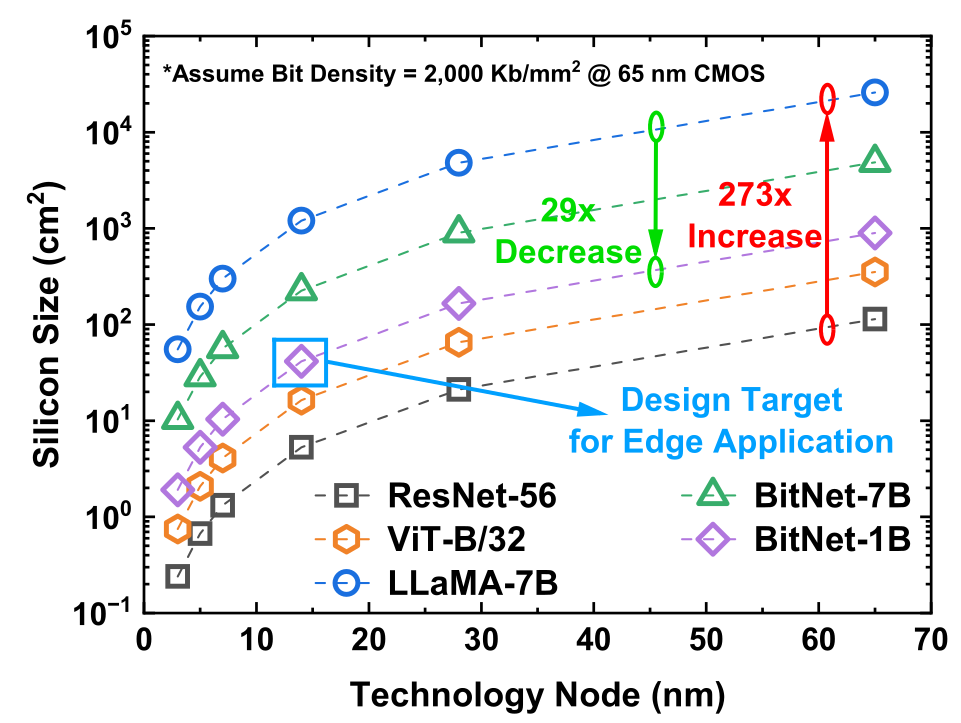
BitNet 系列把 LLM 权重压到三元值 {-1, 0, +1},每个参数约 1.58 bit(BitNet b1.58, arXiv:2402.17764)。这带来三个硬件红利:
- MAC 退化成加减法——乘法器可以整个拆掉
- 权重大量为 0——BitNet 天然稀疏,可以跳过空转
- 1B 参数模型面积塌缩——14nm 下从 LLaMA-7B 的 1,000+ cm² 降到几十 cm²,进入可流片区间
BitROM 的全部设计都围绕这三条展开。三元量化不是论文的贡献(那是 BitNet 的),贡献在于把 CiROM 的每个电路模块都重做一遍去匹配三元权重。
三大创新:BiROMA、TriMLA、DR eDRAM
1. BiROMA:一个晶体管存两个权重
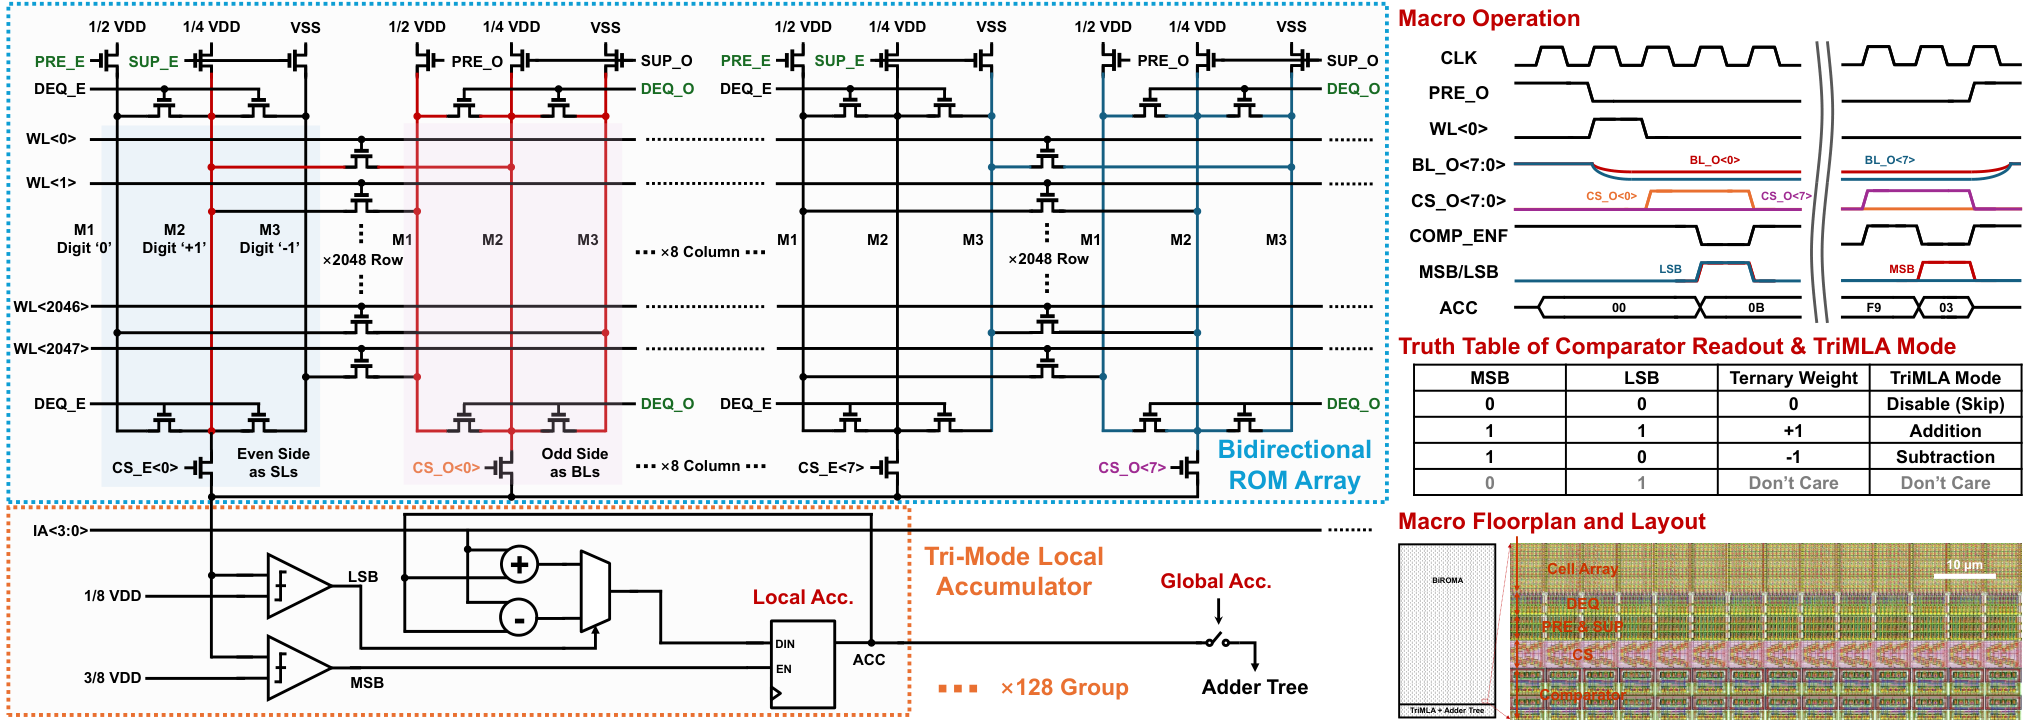
传统 ROM 一个晶体管存 1 bit。BiROMA(Bidirectional ROM Array)的狠活是一个晶体管存两个三元权重——把源极/漏极分别接上代表 0、+1、-1 的三根信号线(1/2 VDD、1/4 VDD、VSS),复用两侧端口读出两个值。阵列 2,048 行 × 1,024 列,信号线走 M1/M2/M3 最小间距规则,存储密度拉到 4,967 Kb/mm²,比上一代数字 CiROM(DCiROM, ASPDAC’25, 487 Kb/mm²)高 10×。
作为 PD 工程师,这条值得细看:E/O 双侧对称结构让每列既可以当源线(驱动)也可以当位线(读出),方向可逆——这是把布线密度和功能复用压到极限的典型手法。论文已完成后端布局验证,外设逻辑(TriMLA + 加法树)只占宏总面积的 4.8%,主要面积全部在 ROM 阵列本体。
2. TriMLA:先局部、后全局的累加策略
传统数字 CiROM 每小组单元配一个加法树,面积被加法树吃掉大半。TriMLA(Tri-Mode Local Accumulator)改成局部先算、全局后算:
- 8 列 BiROMA 共享一个 TriMLA,先做局部累加
- 两个比较器(参考电压 1/8 VDD 和 3/8 VDD)判出权重模式:MSB 判零(权重为 0 直接关断累加器使能,白赚 BitNet 的稀疏性),LSB 判加减
- 通道算完,加法树才做一次全局汇总
8-bit 输出宽度就够了——正负权重对称分布,动态范围天然受限,论文用实测验证不会溢出。支持 4-bit/8-bit 激活,8-bit 走双周期位串行。
3. DR eDRAM:解码期的 KV-cache 自我刷新
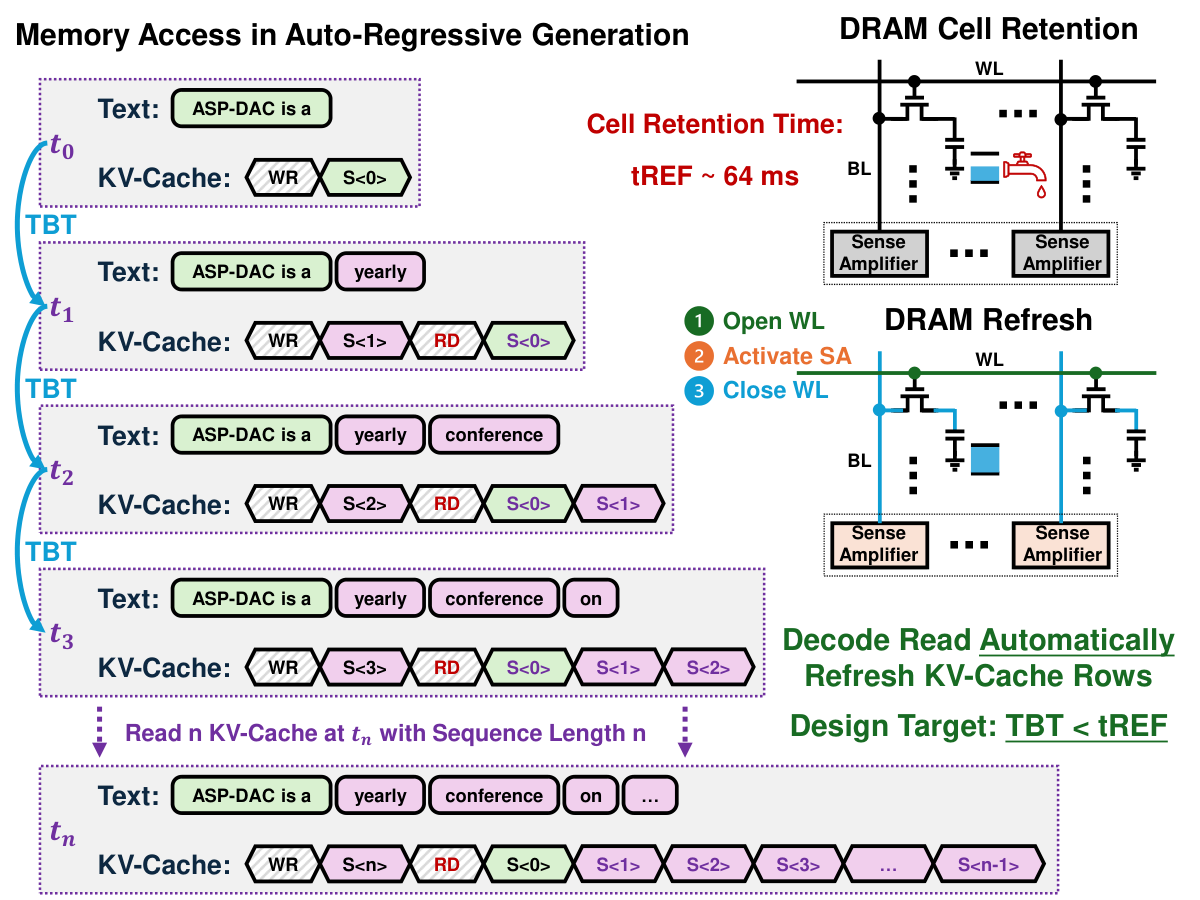
LLM 自回归解码有个被忽视的规律:KV-cache 一旦写入,后续每一步解码都要读它。早期 token 被读的次数最多——序列长度 n 时,第 0 个 token 被读 n 次。
DR eDRAM 的点子很妙:既然每步都读,读操作本身就完成了 DRAM 刷新(DRAM 打开 WL 读出即自动刷新)。只要 token 间间隔(TBT)小于 DRAM 保持时间(典型 64 ms),片内 eDRAM 就完全不需要显式刷新管理。把前 1/4 的早期 token 放片内,序列长度 128 时外部 DRAM 访问减少 43.6%(Fig. 5b)。
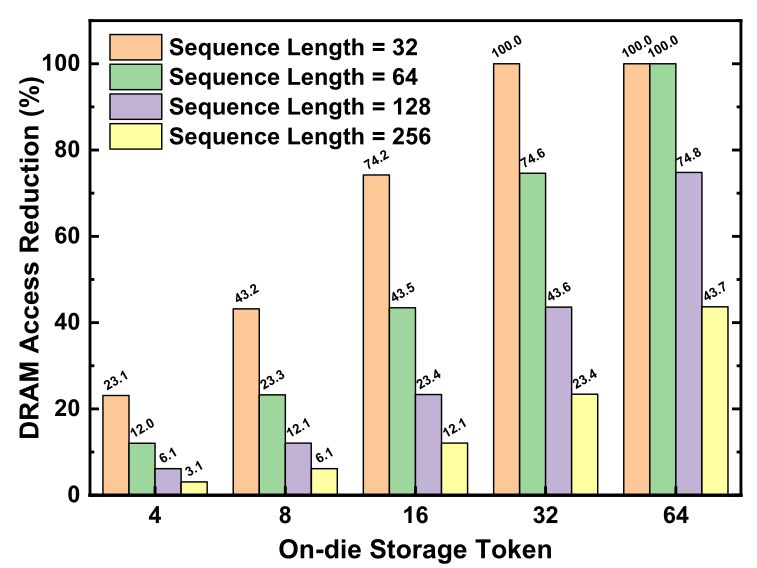
外部 DRAM 访问削减 ≈ 片内缓存早期 token 的比例 × 2
(序列 128、缓存 32 个早期 token → -43.6%)
LoRA 适配:ROM 焊死了,灵活性靠旁路
CiROM 权重流片即固定,这是硬伤。BitROM 用 LoRA 低秩适配器解决:在 attention 的 Value/Output 投影和 MLP 的 Down 投影上插 rank-16 适配器(6-bit 量化权重、8-bit 激活),只加 0.22%–0.3% 参数,多任务迁移效果接近全量微调。消融实验显示放错位置(Query/Key、Gate/Up)效果几乎为零——适配器位置比数量重要得多。有趣的是,BitNet 量化模型任务分数反而超过全精度模型(过拟合更少),这是个反直觉但合理的观察。
实验结果:数字 CiROM 的密度反击
| 设计 | 工艺 | 类型 | 能效 (TOPS/W) | 位密度 (Kb/mm²) | KV 优化 |
|---|---|---|---|---|---|
| Slim-LLaMA (ISSCC’25) | 28nm | 数字 | 255.9 | - | 无 |
| ML-ROM (ESSCIRC’23) | 65nm | 模拟 | 1,324.26 | 375 | 无 |
| ASSCC’24 QLC CiROM | 28nm | 模拟 | 8.49 | 3,648 | 无 |
| CICC’24 混合 SRAM/ROM | 28nm | 模拟 | 7.8/3.8 | 1,657 | 无 |
| DCiROM (ASPDAC’25) | 65nm | 数字 | 38.0/9.0 | 487 | 无 |
| BitROM(本文) | 65nm | 数字 | 20.8/5.2 | 4,967 | -43.6% |
BitROM 的 20.8 TOPS/W 在纸面上不是最高——模拟 CiROM 能飙到 1,324 TOPS/W(ESSCIRC’23)。但注意两点:模拟方案以精度和可靠性为代价(LLM 对计算误差极其敏感,这正是模拟 CiM 在 Transformer 上难以落地的原因),而 BitROM 是全数字、确定性计算,后仿验证过的。它的卖点是密度 + 免权重更新 + KV-cache 优化三者叠加的系统级效率。
14nm 外推:Falcon3-1B(18 层 Transformer、GQA 4 KV head)全模型 16.71 cm² + DR eDRAM 10.24 cm²。论文目标明确是边缘场景——短序列(32–256)、指令执行、问答这类任务,不是数据中心推理。
IC 工程师视角:为什么值得关注
- 数字 CiROM 是 PD 友好的:无模拟宏、无 ADC/DAC,标准单元 + ROM 阵列,65nm 标准数字流程即可做后仿验证。对比模拟 CiM 需要的定制版图、校准电路,工程落地路径完全不同。
- 密度工程的标杆:单管双权重 + M1-M3 最小间距信号线 + E/O 双向复用,把”存储密度”从单元级做到布线级,这是实打实的 physical design 功夫。
- KV-cache 正在成为片内一等公民:DR eDRAM 的”读即刷新”思路,对任何自回归推理芯片的存储层级设计都有启发——哪怕不用 CiROM,片内 KV-cache 缓冲的比例优化逻辑可以直接借鉴。
- 软硬协同的教科书案例:BitROM 的价值不在于某个电路单点突破,而在于把 BitNet 的三元稀疏特性贯穿到阵列、累加器、存储管理每一层。这正符合当前模型-硬件协同设计的行业共识。
局限与冷静判断
- 权重焊死是根本约束:换模型即换芯片,LoRA 只是微调旁路,改变不了 ROM 的不可重编程本质。它赌的是 BitNet 生态成为标准。
- 20.8 TOPS/W 不是性能王者:相对 Slim-LLaMA(255.9 TOPS/W)低一个量级,优势在”免重载”的系统效率与密度,不在峰值能效。
- eDRAM 依赖解码访问模式:prefill 阶段或写密集场景不能照搬”读即刷新”假设。
- 65nm 是证据不是终点:14nm 的 16.71 cm² 是外推估计,真实流片验证还早。
总结
BitROM 给”边缘跑 LLM”指了一条与 HBM 军备竞赛完全不同的路:不堆带宽,而是把权重和计算焊在一起,让模型反过来适应硬件。1.58-bit 三元量化 × 数字 CiROM 的乘积,让十亿参数模型从 1,000+ cm² 的荒谬面积压缩到 27 cm²(含 KV-cache 存储)。密度 10×、DRAM 访问 -43.6%、全数字确定性计算——对做物理设计的人来说,这是一份密度工程的漂亮作业;对做架构的人来说,这是一个”先选模型、再画芯片”的协同设计范本。模型-硬件协同设计的下一站,可能不是更大的 HBM 堆叠,而是这种把数据路径焊死在存储里的极端方案。
| 论文:arXiv:2509.08542 | 代码 | ASP-DAC 2026(DOI: 10.1109/ASP-DAC66049.2026.11420813) |
— Youmoo(㕛木) Solid as teak.