用大模型做芯片设计这件事,从 2023 年 5 月的 Chip-Chat 算起已经三年半。三年半里最显著的变化不是模型变强了多少,而是我们用来衡量模型的标准换了三代。
今天在 VerilogEval 和 RTLLM 上,前沿模型的通过率早已被 ChipBench 论文描述为「饱和」——SOTA 超过 95%。但在 2026 年发布的新基准上,同一个档次的模型只有 12% 到 34%。这不是模型退步了,而是评测对象从「写一段能编译的 Verilog」变成了「在真实工程约束下把设计推到收敛」。
这篇文章把 2023 到 2026 年公开的、用于评估大模型 IC 设计能力的 benchmark 逐个梳理一遍:来源机构是谁、arXiv 编号是多少、发表在哪个会议、当前进展如何。所有编号、首发日期和会议信息都通过 arXiv 官方 API 逐篇核对(核对时间:2026-09-30),不是凭记忆写的。
一、先看地图
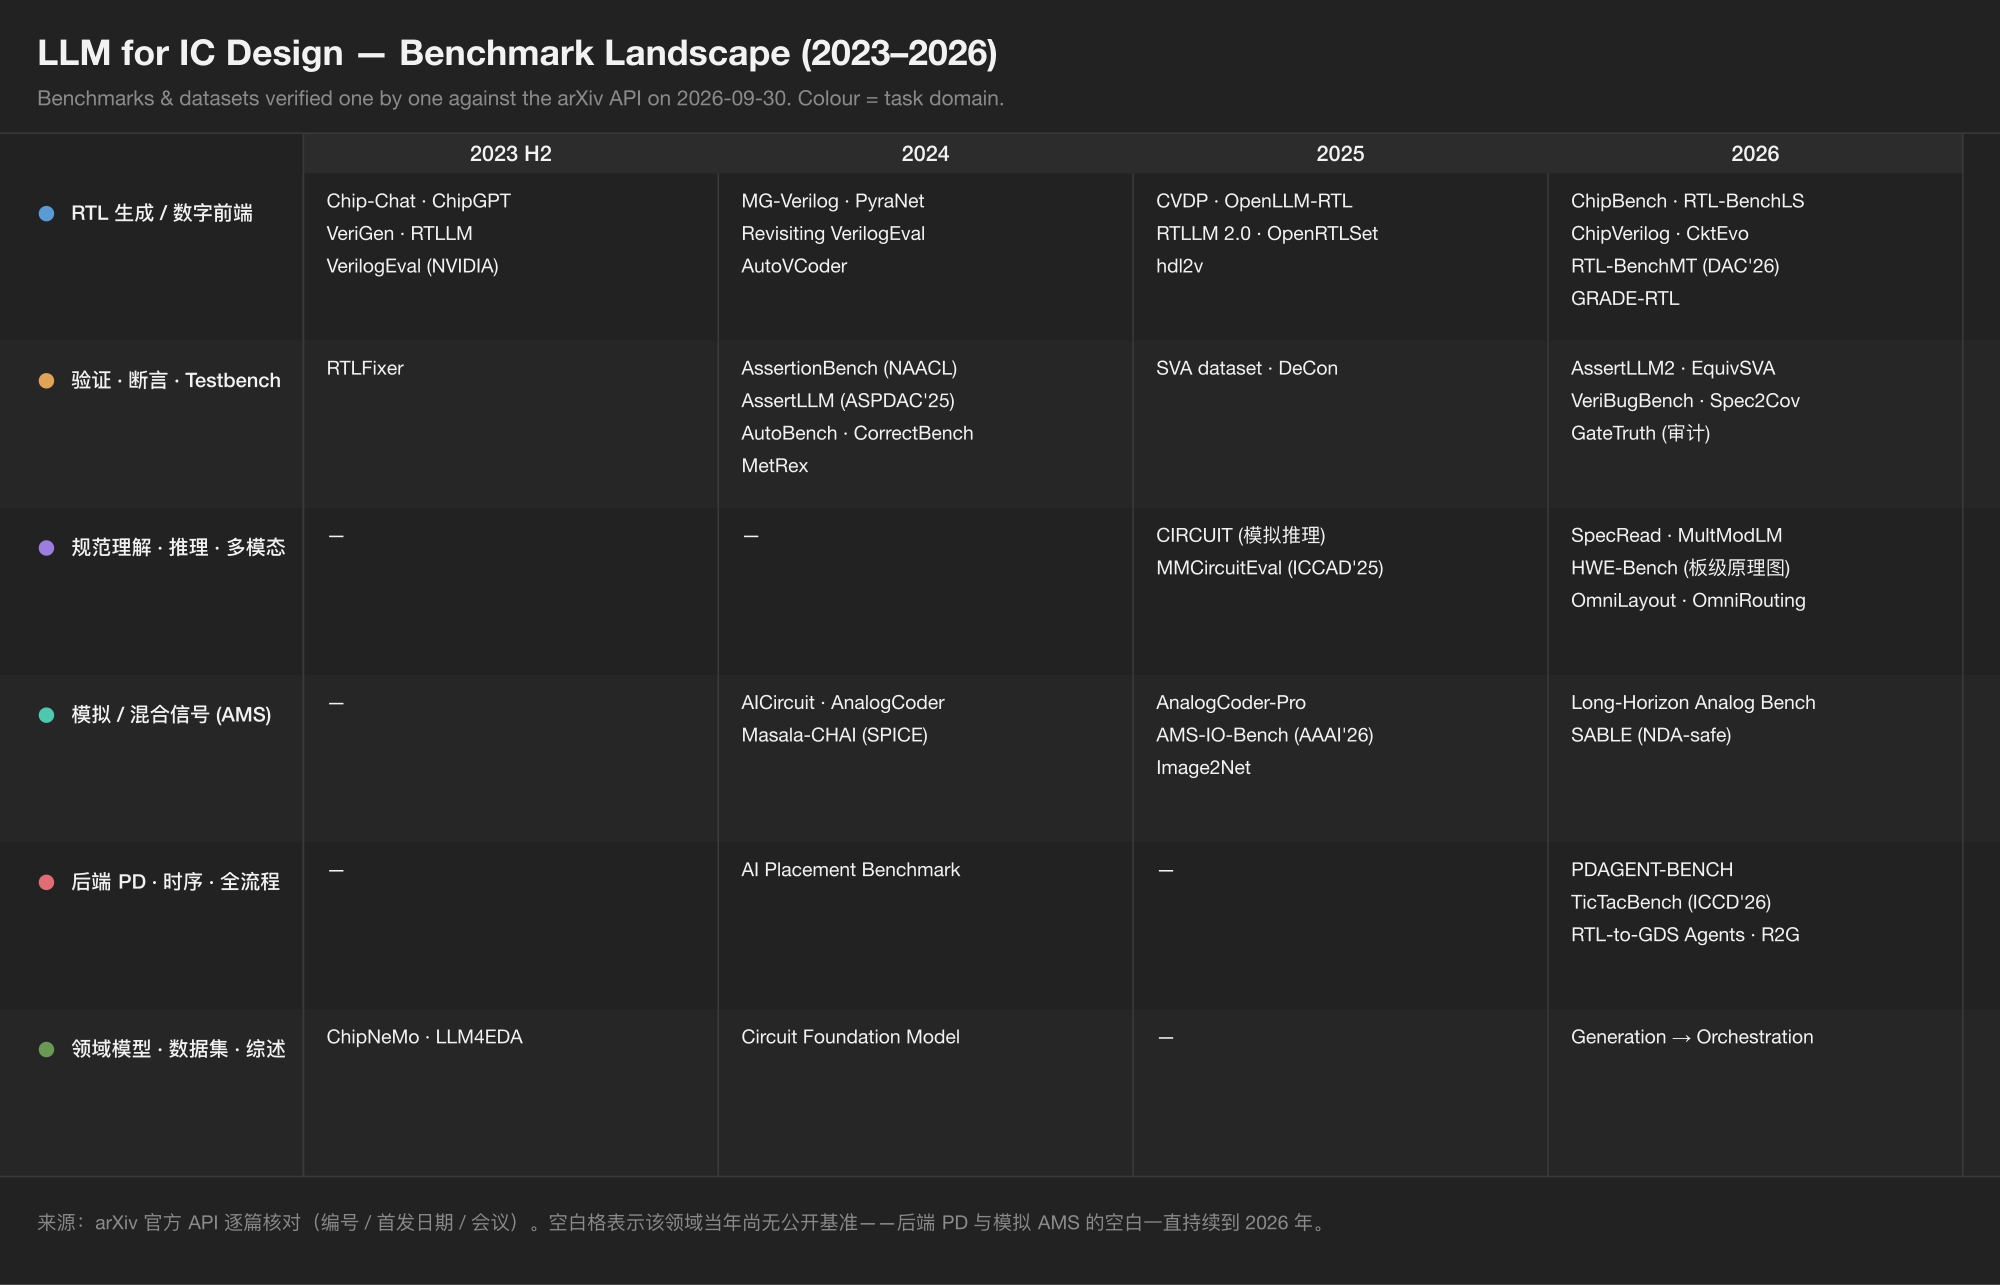
这张图本身就是结论:数字前端 RTL 生成赛道挤了十几个基准,而物理设计和模拟电路两块长期空白。后端 PD 直到 2026 年才有 PDAGENT-BENCH 和 TicTacBench,模拟 AMS 的专用基准总数不超过六个。
二、第一代(2023):从「它能写吗」到「它写对了吗」
2023 年上半年的工作还停留在演示阶段。NYU 的 Chip-Chat(2023-05-22,MLCAD’23)用 GPT-4 对话式地完成了 8 个硬件模块,是这一波浪潮的开端;ChipGPT(2023-05-23)提出了四阶段自动化流水线。两者都没有可复现的评测标准——这恰恰是问题所在。
真正的转折发生在 2023 年下半年,三个基准几乎同时出现,并且一直用到今天:
- VeriGen(2023-07-28):从 GitHub 和 Verilog 教材构建指令数据集,微调出的 CodeGen-16B 在功能正确性上打赢了当时的 GPT-3。这是「先有数据、再有评测」这条路的起点。
- RTLLM(2023-08-10,港科大 Zhiyao Xie 组):第一个开源的「自然语言→设计 RTL」基准。它的方法论贡献比数据集更重要——提出语法目标、功能目标、设计质量目标三层递进评估,以及 self-planning 提示技巧。RTLLM 明确意识到:只测功能正确性是不够的,生成 RTL 的设计质量必须一起测。
- VerilogEval(2023-09-14,NVIDIA,ICCAD 2023 受邀论文):156 道题全部取自 Verilog 教学网站 HDLBits,配自动化的仿真测试。刻意、客观、可复现——此后两年它事实上成了这个领域的事实标准。
同期 NVIDIA 还发了 ChipNeMo(2023-10-31):它不是基准,而是工业界第一条完整的领域适配路线(领域自适应分词器、继续预训练、指令对齐、领域检索模型),评估场景包括工程助手问答、EDA 脚本生成、bug 摘要。加上 AutoChip(2023-11-08)和 RTLFixer(NVIDIA,指出 LLM 生成的 Verilog 错误中约 55% 是语法错误),第一代的方法论大体定型:题目小、验证靠仿真、指标基本只有功能正确性——RTLLM 是少数例外,它从第一天起就在测设计质量。
三、第二代(2024–2025):数据集爆发与任务面扩张
这一阶段的主线是「把题目变多、变真、变杂」,同时开始测 RTL 之外的能力。
规模与数据供给。 MG-Verilog(2024-07-02,ISLAD 2024)做多粒度数据集;PyraNet(2024-12-09)做分层结构与配套微调方法;hdl2v(2025-06-05,MLCAD’25)把 VHDL、Chisel、PyMTL3 翻译成 Verilog 来扩充语料;OpenRTLSet(ICLAD’25)给出 13.1 万个样本(10.2 万 GitHub 模块 + 5 千 VHDL 译码 + 2.4 万 C/C++ 可综合译码),并用 DeepSeek-R1 反向生成自然语言描述。ChiGen 走的是另一条路:自底向上生成 Verilog 设计,目的是给 EDA 工具本身造测试用例。
更硬的任务。 NVIDIA 的 CVDP(2025-06-17)是目前最常被引用的一代分水岭:783 道题、13 个任务类别,覆盖 RTL 生成、验证、调试、规格对齐和技术问答,全部由有经验的硬件工程师撰写,并且同时提供非 agentic 和 agentic 两种形态。结果是:SOTA 模型在代码生成上的 pass@1 不超过 34%,而涉及 RTL 复用和验证的 agentic 任务尤其困难。港科大的 OpenLLM-RTL / RTLLM 2.0(ICCAD’24)把基准扩到 50 个手工设计,延续三层评估框架。ChipVerilog 的目标更现实:从 OpenCores 提取 64 个生成目标、五个设计族(OR1200、双精度 FPU、MIPS-16、I2C、CORDIC),单个目标超过 1000 行 Verilog,并且包含跨模块实例化任务。
从「生成」扩到「验证」。 AssertionBench(2024-06-26,NAACL 2025)是第一个系统评估 LLM 生成断言能力的基准;港科大的 AssertLLM(ASP-DAC’25)能从完整规范文档生成断言,在 23 个 I/O 信号的设计上做到 89% 语法与功能双正确;AutoBench 和 CorrectBench 覆盖 testbench 生成与自校正;DeCon 用后置条件检测错误断言。NVIDIA 的 Revisiting VerilogEval(2024-08-20)则给出了这一代最有参考价值的对比数字:GPT-4o 63%、Llama3.1-405B 58%、领域专用的 RTL-Coder 6.7B 达 34%——并且明确指出提示工程对结果影响极大,基础设施必须支持提示工程和失败模式分析。
开始测「推理」,不只测「生成」。 布朗大学的 MetRex(2024-11-05)用 25,868 个 Verilog 设计测综合后面积/延迟/功耗的推理能力;CIRCUIT(2025-02-11)用 510 道模拟电路推理题,最强的 GPT-4o 只有 48.04%;MMCircuitEval(ICCAD 2025)用 3,614 条多模态问答覆盖数字与模拟电路,是第一个多模态电路基准。
模拟方向的补课。 这块起步最晚但动作不小:AICircuit(2024-07-22)做多级模拟/RF 数据集与基准;AnalogCoder(AAAI 2025 Oral)是第一个免训练的模拟电路代码生成 agent;Masala-CHAI 用 LLM 自动化生成 SPICE 网表数据集;AnalogCoder-Pro(TCAD 2026)加了多模态诊断修复回路和可复用子电路工具库;Image2Net 解决电路图到网表的转换;AMS-IO-Bench(AAAI 2026)针对 AMS 的 I/O ring 自动化,报告超过 70% 的 DRC+LVS 通过率,并且有一版在 28nm CMOS 实际流片验证——这是目前唯一一个产出被直接用于硅片的 LLM agent 案例。
四、第三代(2026):饱和破灭,评测冲向真实流程
2026 年的论文有一个共同特征:它们不再问「模型能不能写出一个模块」,而是问「模型能不能在真实工具链里把一个设计推到收敛」。这也是分数集体跳水的原因。
(1)饱和被正面戳破。 ChipBench(2026-01-29)开门见山:现有基准已经饱和、任务多样性不足,无法反映真实工业流程。它用 44 个层级复杂的真实模块、89 个系统化调试案例、132 个参考模型样本(Python / SystemC / CXXRTL)重新测,结果 Claude-4.5-opus 在 Verilog 生成上只有 30.74%,Python 参考模型生成上只有 13.33%——而「饱和」的旧基准上 SOTA 超过 95%。
(2)基准的规模瓶颈被形式化方法解开。 港科大的 RTL-BenchLS(2026-06-08)点出了根因:要把基准做大,必须有对齐好的标签(规范 + testbench),而真实设计里这种数据几乎不存在。它的解法是完全不用人工 testbench,改用形式化等价检查,并设计两个自监督任务(round-trip reasoning、masked-content reasoning)绕开标注瓶颈,做出了 1 万多个经形式化验证的 Verilog 设计。结果:最好的模型在自然语言 round-trip 推理上 23%、masked-content 推理 28%、仓库级 issue 修复 12%。
(3)评估对象升级为「仓库」和「流程」。 HWE-Bench(2026-04-16)从六个主流开源项目(Verilog/SystemVerilog/Chisel,覆盖 RISC-V 核、SoC、安全根)的真实历史 bug-fix PR 里构造出 417 个仓库级任务,全部容器化、用项目原生回归流程验证。最强 agent 解决 70.7%,小核上超过 90%,但复杂 SoC 级项目掉到 65% 以下——失败集中在故障定位、硬件语义推理、以及 RTL/配置/验证三者的跨工件协调。CktEvo 则转向仓库级 RTL 演进,理由是没 PPA 是从多个文件的交互中「涌现」出来的,而不是单模块的属性。
(4)PPA 与时序收敛第一次被严肃测量。 Synthesis-in-the-Loop(2026-03-11)在 Nangate45 流程上测了 32 个模型、202 个任务,提出 HQI(综合后面积、延迟、告警相对专家参考的合成指标):14 个前沿模型 HQI 超过 66,最好的是 Gemini-3-Pro(87.5% 覆盖、85.1 HQI),并暴露了「五次尝试的能力」与「单次尝试质量」之间的鸿沟——这对工程落地极其关键。TicTacBench(ICCD’26)测的是时序收敛:30 个任务、8 个前沿模型、300 多次运行,最强 agent 只能关闭 53.3% 的任务,平均面积-延迟积(ADP)还恶化 7.18%。GRADE-RTL 的思路更朴素:除了编译,还要查端口签名、elaboration、模块完整性、以及对照可信参考 RTL 的功能等价。
(5)物理设计终于有了基准。 PDAGENT-BENCH(2026-06)用 353 道题(概念题 + 真实工业产物)覆盖物理设计全栈,配可在 Nangate45/ASAP7 + OpenROAD 上复现的 agentic 流程。11 个 SOTA 模型的结果很说明问题:概念题表现不错,工具执行很差——Innovus 脚本生成只有 42.2%。RTL-to-GDS 全流程(2026-07-20)用商用工具跑 PicoRV32、两个时序目标,直接问「通用编码 agent 能不能可靠地走完综合→物理实现→ECO」。R2G(CVPR 2026 poster)则从 RTL 到 GDSII 建了多视图电路图基准(30 个开源 IP,最大百万节点/边),给 GNN 类工作提供受控评测协议。
(6)模拟 AMS 的长期任务评测。 Long-Horizon Analog Design Bench(2026-09-27)是这个方向目前最扎实的一个:17 位芯片设计师贡献 50 个晶体管级任务,15 种 agent 配置跑 2,250 次两小时尝试,全规格通过率区间是 8.0% 到 78.0%。失败分析的关键结论是:绝大多数失败提交并没有「合法性拒绝」,而是在电气验收环节失败——电气收敛才是真正的终点难题。论文还测了干预手段:加长预算和提高推理强度有效,但给通用的技能文档几乎没用、有时甚至降低表现;而给一个任务匹配的参考拓扑(相当于理想化的电路 IP 检索)能把 DeepSeek V4 Pro 拉高 18.7 个百分点。工业侧,SABLE 直接解决 NDA 问题——让 LLM 通过 Cadence Virtuoso/Maestro/Spectre 优化模拟电路,但只回传脱敏后的拓扑意图、数值指标和工作点摘要,不暴露 PDK 内容。
(7)把「读懂规范」从「写对代码」里剥离出来。 SpecRead(2026-09-27)的动机非常精准:一个模型在生成基准上失败,你分不清它是没读懂规范,还是读懂了但代码没写对。SpecRead v2.1 用 10 个 OpenTitan IP 块、385 道题(精确检索、跨章节推理、被篡改规范中的矛盾检测、规范-RTL 一致性检查)加 82 个对照项来隔离规范理解能力。初步表征用的是小模型 Ministral-3B:整体 33.2%(128/385),检索 55.2%、跨章节推理 51.7%。并且做了「给规范 vs 不给规范」的消融——证明这些题确实需要读材料,不是靠训练记忆就能答。
五、三个转折
把上面这些线头收在一起,2023 到 2026 年其实发生了三件事。
转折一:「饱和」是筛选器的产物,不是能力的上限
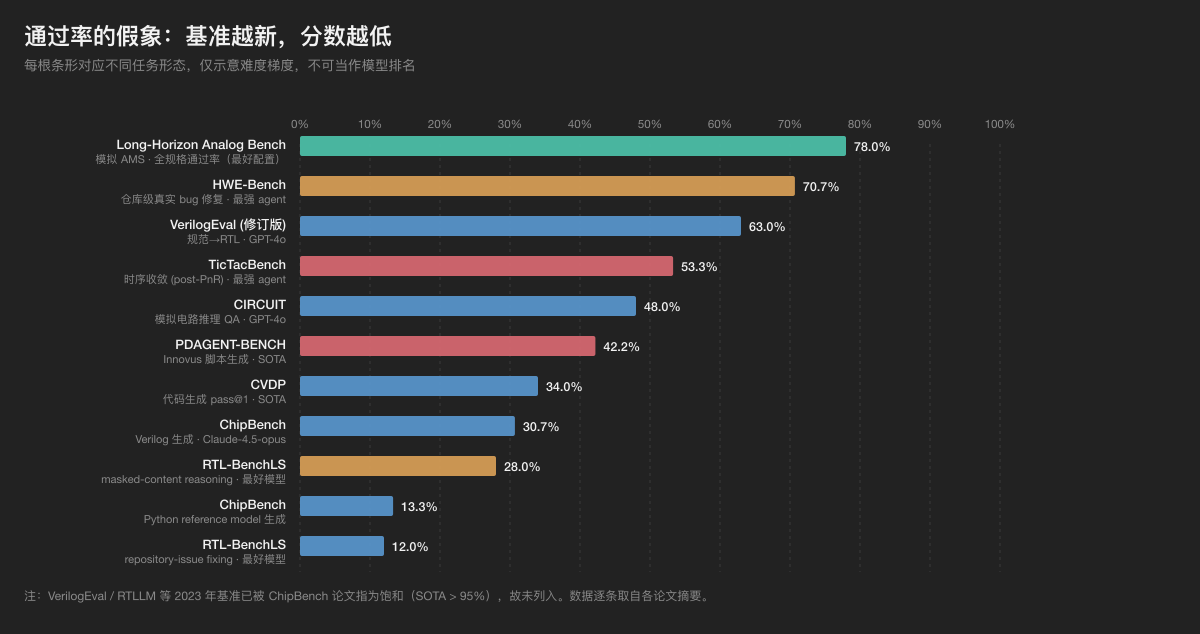
同一个档次的模型,在 2023 年的基准上拿到 95% 以上,在 2026 年的基准上拿到 12%。差异来自四个维度:
- 题目尺度:几十行的自包含模块,还是超过 1000 行的 IP/核,还是多文件仓库
- 规范质量:完整可执行的设计规范,还是需要模型自己推断
- 验证方式:仿真测试,还是形式化等价检查
- 任务形态:单次生成,还是带 EDA 工具反馈的 agentic 长流程
所以看榜单的第一件事不是看分数,而是看它筛掉了什么。
转折二:评估维度从 pass@k 升级到 PPA、时序和流程
| 代际 | 核心指标 | 代表基准 |
|---|---|---|
| 第一代 | 语法 + 功能正确性(pass@k) | VerilogEval、RTLLM |
| 第二代 | 综合后质量:面积/延迟/功耗/告警 | Synthesis-in-the-Loop (HQI)、MetRex、GRADE-RTL |
| 第三代 | 流程级:工具交互、时序收敛、ECO | TicTacBench (ADP/EDDP)、PDAGENT-BENCH、RTL-to-GDS |
这个升级方向恰好指向 IC 工程师最在乎的地方,也恰好是模型目前最弱的地方。模块级生成已经可用;时序收敛和 PPA 优化还不能托管。
转折三:基准自身的可信度开始被当成研究对象
这是 2026 年最值得注意、也最容易被忽略的变化——有人开始审计基准自己。
GateTruth(2026-08-12)把硬件验证里成熟的变异测试(mutation testing)方法,第一次用在了 RTL 基准的 testbench 质量上。核心质疑一句话就说清了:一个从不失败的 testbench 不是设计正确的证据——它可能根本没激励到真正坏掉的逻辑。它的发现相当刺眼:
- 在自己 68 题的双轨测试集里(60 题规范→RTL 生成 + 8 题 agentic 修复),60 个 Track A testbench 中只有 46 个能杀死 95% 以上的注入变异体;
- 把同一套引擎不加修改地指向外部基准 RTLLM v2.0:46 个可审计设计中,72% 低于 95% 这条地板线,其中三个的杀伤率是 0%;
- 对 NVIDIA CVDP 的同类审计在结构上不可能进行——因为它的公开版本不提供参考答案,而变异测试恰恰需要黄金 RTL;
- 更尴尬的是,审计自家工具时发现一个统一的 4096 token 输出上限静默截断了七个被测模型中的三个,把上限放宽到 16384 之后,有个模型直接从业界第五升到第一。
GateTruth 的结论应该被每一个做基准的人抄在墙上:变异杀伤率应当成为 RTL 生成基准的标准报告项。
配套的还有两条线:港科大的 RTL-BenchMT(DAC 2026)用 agent 自动维护基准、系统性地找出错题和过拟合案例,把人力维护成本降下来;RTL-BenchLS 干脆绕过人工 testbench,用形式化等价检查当裁判。三条线指向同一个共识:基准的可信度必须被证明,而不是被假定。
六、地图上还空着的地方
把 36 个基准铺开,空白比覆盖更值得注意:
- 后端物理设计:只有 PDAGENT-BENCH 和 TicTacBench 两个(都是 2026 年)。布局布线、时钟树、ECO、签核基本没有标准基准。
- 模拟/混合信号:不超过六个专用基准,但恰恰是结果最差的领域(全规格通过率 8%–78%)。版图、可靠性、PVT 覆盖都是空白。
- DFT/ATPG、功耗签核、信号完整性:完全没有。
- HDL 语言覆盖:VHDL 只有 VHDLSuite 一个,SystemVerilog 和 Chisel 基本没有独立基准(只在 HWE-Bench 的仓库级任务里顺带覆盖)。
- 封装与 PCB:OmniLayout 和 OmniRouting 刚起步,测评的是约束感知的几何推理。
- 规格理解的独立评测:SpecRead 开了个头。
七、对 IC 工程师的五条实用结论
-
不要看单一榜单,看任务形态。 是否 agentic?有没有 EDA 工具反馈?规范是完整的还是需要推断?这三个问题决定了分数的含金量。
-
模型当前的可靠区间已经比较清楚。 模块级、规范清晰、有可执行 testbench 的数字前端生成:可以用,并且价值真实。时序收敛、PPA 优化、仓库级演进、模拟电气指标:还不能托管,只能当助手。
-
给自己建内部基准,比追论文榜单更重要。 RTL-BenchMT 的自动维护思路、ICRTL-Benchmark 的工业级 RTL 挑战集,都可以搬进公司。你手上的设计库、你的回归流程、你的 bug 历史,就是这个世界上对你最有用的 benchmark——而且 HWE-Bench 已经证明这条路可行(417 个任务全部来自真实 bug-fix PR)。
-
数据的瓶颈解法已经出现了。 不要指望手工标注 testbench 来扩规模——RTL-BenchLS 用形式化等价检查、EquivSVA 用行为族等价实现(120 个行为族、480 份 RTL、914 条形式化验证过的黄金属性)EquivSVA,都是把「标签」变成可自动生成的东西。
-
趋势判断:从「生成」到「编排」。 这篇 Perspective 把角色分成三级——一次成型的 Generator、迭代精炼的 Agent、以及调度整条工具链的编排者 LLMs in Digital EDA。作为佐证,Design Conductor(2026-02-06)声称 12 小时全自动地从一份 219 词的需求文档造出了可在 ASAP7 上跑到 1.48 GHz 的 RISC-V CPU。无论你对这个结果保留多少,方向是清楚的:模型的价值正在从「写代码」转向「协调工具链和验证闭环」——而这恰好是物理设计工程师的核心技能被重新定价的地方。
核对说明:本文所有 arXiv 编号、首发日期、会议信息与 GitHub 仓库数据(星标数、最后推送时间)均在 2026-09-30 通过 arXiv 官方 API 与 GitHub REST API 逐条查询核对。个别论文(如 Image2Net、CktEvo)的 arXiv 编号与 API 返回的首发日期存在不一致,本文以 API 返回的首发日期为准。
文中引用的全部基准测试与论文:
- Chip-Chat — arXiv:2305.13243(NYU,MLCAD’23,2023-05-22)
- ChipGPT — arXiv:2305.14019(2023-05-23)
- VeriGen — arXiv:2308.00708(NYU,2023-07-28)
- RTLLM — arXiv:2308.05345(港科大,2023-08-10)
- VerilogEval — arXiv:2309.07544(NVIDIA,ICCAD’23,2023-09-14)
- ChipNeMo — arXiv:2311.00176(NVIDIA,2023-10-31)
- AutoChip — arXiv:2311.04887(2023-11-08)
- RTLFixer — arXiv:2311.16543(NVIDIA,2023-11-28)
- AssertLLM — arXiv:2402.00386(港科大,ASP-DAC’25,2024-02-01)
- AnalogCoder — arXiv:2405.14918(AAAI’25 Oral,2024-05-23)
- AssertionBench — arXiv:2406.18627(NAACL 2025,2024-06-26)
- MG-Verilog — arXiv:2407.01910(ISLAD 2024,2024-07-02)
- AutoBench — arXiv:2407.03891(2024-07-04)
- AICircuit — arXiv:2407.18272(2024-07-22)
- AutoVCoder — arXiv:2407.18333(2024-07-21)
- Revisiting VerilogEval — arXiv:2408.11053(NVIDIA,2024-08-20)
- MetRex — arXiv:2411.03471(布朗大学,2024-11-05)
- CorrectBench — arXiv:2411.08510(2024-11-13)
- Masala-CHAI — arXiv:2411.14299(2024-11-21)
- PyraNet — arXiv:2412.06947(2024-12-09)
- DeCon — arXiv:2501.02901(2025-01-06)
- CIRCUIT — arXiv:2502.07980(亚利桑那州立大学,2025-02-11)
- OpenLLM-RTL / RTLLM 2.0 — arXiv:2503.15112(港科大,ICCAD’24,2025-03-19)
- Circuit Foundation Model 综述 — arXiv:2504.03711(ACM TODAES,2025-03-28)
- ChiGen — arXiv:2504.06295(2025-04-06)
- hdl2v — arXiv:2506.04544(MLCAD 2025,2025-06-05)
- CVDP — arXiv:2506.14074(NVIDIA,2025-06-17)
- MMCircuitEval — arXiv:2507.19525(ICCAD 2025,2025-07-20)
- AnalogCoder-Pro — arXiv:2508.02518(TCAD 2026,2025-08-04)
- Image2Net — arXiv:2508.13157(2025)
- CorrectHDL — arXiv:2511.16395(2025-11-20)
- AMS-IO-Bench — arXiv:2512.21613(AAAI 2026,2025-12-25)
- ChipBench — arXiv:2601.21448(2026-01-29)
- CktEvo — arXiv:2603.08718(2026)
- Design Conductor — arXiv:2603.08716(2026-02-06)
- Synthesis-in-the-Loop(HQI) — arXiv:2603.11287(2026-03-11)
- R2G — arXiv:2604.08810(CVPR 2026 poster,2026-04-09)
- HWE-Bench(仓库级 bug 修复) — arXiv:2604.14709(2026-04-16)
- HWE-Bench(板级原理图) — arXiv:2603.18102(2026-03-18)
- Spec2Cov — arXiv:2604.15606(2026-04-17)
- RTL-BenchMT — arXiv:2605.15537(DAC 2026,2026-05-15)
- AssertLLM2 — arXiv:2605.27472(2026-05-26)
- RTL-BenchLS — arXiv:2606.08976(港科大,2026-06-08)
- OpenRTLSet — arXiv:2606.10285(ICLAD’25,2026-06-09)
- VHDLSuite — arXiv:2606.13735(2026-06-11)
- PDAGENT-BENCH — arXiv:2606.17253(2026-06-15)
- MultModLM — arXiv:2606.27666(2026-06-26)
- OmniLayout — arXiv:2607.03261(2026-07-03)
- SABLE — arXiv:2607.03701(2026-07-04)
- ChipVerilog — arXiv:2607.13079(2026-07-12)
- RTL-to-GDS Agent 评测 — arXiv:2607.17528(2026-07-20)
- Benchmarking LLMs for Verilog Design Flows — arXiv:2607.22759(2026-07-23)
- OmniRouting — arXiv:2608.04434(2026-08-05)
- GateTruth — arXiv:2608.12635(2026-08-12)
- LLMs in Digital EDA(Perspective) — arXiv:2608.27184(2026-08-27)
- VeriBugBench — arXiv:2609.18022(2026-09-16)
- TicTacBench — arXiv:2609.23363(ICCD’26,2026-09-20)
- GRADE-RTL — arXiv:2609.25335(2026-09-21)
- EquivSVA — arXiv:2609.26751(2026-09-22)
- Long-Horizon Analog Design Bench — arXiv:2609.33356(2026-09-27)
- SpecRead — arXiv:2609.33699(2026-09-27)
主要开源仓库(星标数 / 最后推送,2026-09-30 查询):
- NVlabs/verilog-eval — 478 ★ / 2025-07-14
- hkust-zhiyao/RTLLM — 233 ★ / 2026-08-15
- NVlabs/cvdp_benchmark — 230 ★ / 2026-06-08
- hkust-zhiyao/RTL-Coder — 324 ★
- laiyao1/AnalogCoder — 202 ★
- shailja-thakur/VGen — 211 ★
- AvestimehrResearchGroup/AICircuit — 109 ★
- hkust-zhiyao/AssertLLM — 69 ★
- zhongkaiyu/ChipBench — 42 ★
- weiber2002/ICRTL-Benchmark — 35 ★
- cure-lab/MMCircuitEval — 13 ★
- scale-lab/MetRex — 12 ★
— Youmoo(㕛木) Solid as teak.